2023年4月

按需加载 -> graphQL
天秀老接口存在一个问题,我们每次请求1000条数据,返回的数组中,每一条数据都有上百个字段,其实我们前端只用到其中的10个字段而已。

如何从一百多个字段中,抽取任意n个字段,这就用到graphQL。

graphQL按需加载数据只需要三步:

  • 定义数据池 root
  • 描述数据池中数据结构 schema
  • 自定义查询数据 query

定义数据池
我们针对屌丝追求女神的场景,定义一个数据池,如下:

// 数据池
var root = {
    girls: [{
        id: 1,
        name: '女神一',
        iphone: 12345678910,
        weixin: 'xixixixi',
        height: 175,
        school: '剑桥大学',
        wheel: [{ name: '备胎1号', money: '24万元' }, { name: '备胎2号', money: '26万元' }]
    },
    {
        id: 2,
        name: '女神二',
        iphone: 12345678910,
        weixin: 'hahahahah',
        height: 168,
        school: '哈佛大学',
        wheel: [{ name: '备胎3号', money: '80万元' }, { name: '备胎4号', money: '200万元' }]
    }]
}

里面有两个女神的所有信息,包括女神的名字、手机、微信、身高、学校、备胎集合等信息。

接下来我们就要对这些数据结构进行描述。

描述数据池中数据结构

const { buildSchema } = require('graphql');

// 描述数据结构 schema
var schema = buildSchema(`
    type Wheel {
        name: String,
        money: String
    }
    type Info {
        id: Int
        name: String
        iphone: Int
        weixin: String
        height: Int
        school: String
        wheel: [Wheel]
    }
    type Query {
        girls: [Info]
    }
`);

上面这段代码就是女神信息的schema。

首先我们用type Query定义了一个对女神信息的查询,里面包含了很多女孩girls的信息Info,这些信息是一堆数组,所以是[Info]

我们在type Info中描述了一个女孩的所有信息的维度,包括了名字(name)、手机(iphone)、微信(weixin)、身高(height)、学校(school)、备胎集合(wheel)

定义查询规则
得到女神的信息描述(schema)后,就可以自定义获取女神的各种信息组合了。

比如我想和女神认识,只需要拿到她的名字(name)和微信号(weixin)。查询规则代码如下:

const { graphql } = require('graphql');

// 定义查询内容
const query = `
    { 
        girls {
            name
            weixin
        }
    }
`;

// 查询数据
const result = await graphql(schema, query, root)

筛选结果如下:

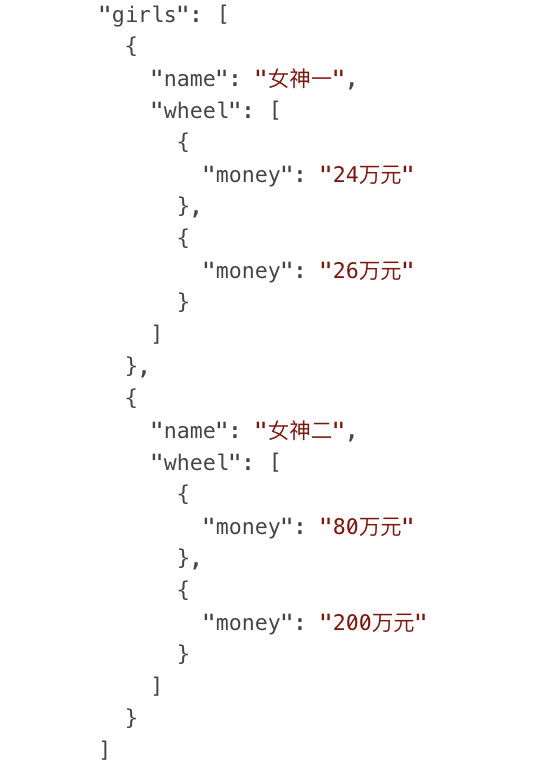
又比如我想进一步和女神发展,我需要拿到她备胎信息,查询一下她备胎们(wheel)的家产(money)分别是多少,分析一下自己能不能获取优先择偶权。查询规则代码如下:

const { graphql } = require('graphql');

// 定义查询内容
const query = `
    { 
        girls {
            name
            wheel {
                money
            }
        }
    }
`;

// 查询数据
const result = await graphql(schema, query, root)

筛选结果如下:
2023-04-11T11:47:06.png

我们通过女神的例子,展现了如何通过graphQL按需加载数据。

映射到我们业务具体场景中,天秀接口返回的每条数据都包含100个字段,我们配置schema,获取其中的10个字段,这样就避免了剩下90个不必要字段的传输。

graphQL还有另一个好处就是可以灵活配置,这个接口需要10个字段,另一个接口要5个字段,第n个接口需要另外x个字段

按照传统的做法我们要做出n个接口才能满足,现在只需要一个接口配置不同schema就能满足所有情况了。

感悟
在生活中,咱们舔狗真的很缺少graphQL按需加载的思维

渣男渣女,各取所需

你的真情在名媛面前不值一提

我们要学会投其所好

上来就亮车钥匙,没有车就秀才艺

今晚我有一条祖传的染色体想与您分享一下

行就行,不行就换下一个

直奔主题,简单粗暴

缓存 -> redis
第二个优化手段,使用redis缓存

天秀老接口内部调用了另外三个老接口,而且是串行调用,极其耗时耗资源,秀到你头皮发麻

我们用redis来缓存天秀接口的聚合数据,下次再调用天秀接口,直接从缓存中获取数据即可,避免高耗时的复杂调用,简化后代码如下:

const redis = require("redis");
const { promisify } = require("util");

// 链接redis服务
const client = redis.createClient(6379, '127.0.0.1');

// promise化redis方法,以便用async/await
const getAsync = promisify(client.get).bind(client);
const setAsync = promisify(client.set).bind(client);

async function list() {
    // 先获取缓存中数据,没有缓存就去拉取天秀接口
    let result = await getAsync("缓存");
    if (!result) {
          // 拉接口
          const data = await 天秀接口();
          result = data;
          // 设置缓存数据
          await setAsync("缓存", data)
    }
       return result;
}

list(); 

先通过getAsync来读取redis缓存中的数据,如果有数据,直接返回,绕过接口调用,如果没有数据,就会调用天秀接口,然后setAsync更新到缓存中,以便下次调用。因为redis存储的是字符串,所以在设置缓存的时候,需要加上JSON.stringify(data),为了便于大家理解,我就不加了,会把具体细节代码放在github中。

将数据放在redis缓存里有几个好处

可以实现多接口复用、多机共享缓存

这就是传说中的云备胎

追求一个女神的成功率是1%

同时追求100个女神,那你获取到一个女神的概率就是100%

鲁迅《狂人日记》里曾说过:“舔一个是舔狗,舔一百个你就是战狼”

你是想当舔狗还是当战狼?

来吧,缓存用起来,redis用起来

轮询更新 -> schedule
最后一个优化手段:轮询更新 -> schedule

女神的备胎用久了,会定时换一批备胎,让新鲜血液进来,发现新的快乐

缓存也一样,需要定时更新,保持与数据源的一致性,代码如下:

const schedule = require('node-schedule');

// 每个小时更新一次缓存
schedule.scheduleJob('* * 0 * * *', async () => {
    const data = await 天秀接口();
    // 设置redis缓存数据
    await setAsync("缓存", data)
});

我们用node-schedule这个库来轮询更新缓存, 0 *这个的意思就是设置每个小时的第0分钟就开始执行缓存更新逻辑,将获取到的数据更新到缓存中,这样其他接口和机器在调用缓存的时候,就能获取到最新数据,这就是共享缓存和轮询更新的好处。

早年我在当舔狗的时候,就将轮询机制发挥到淋漓尽致

每天向白名单里的女神,定时轮询发消息

无限循环云跪舔三件套:

“啊宝贝,最近有没有想我”
“啊宝贝早安安”
“宝贝晚安,么么哒”
虽然女神依然看不上我

但仍然时刻准备着为女神服务!

结尾
经过以上三个方法优化后

接口请求耗时从3s降到了860ms

这些代码都是从业务中简化后的逻辑

真实的业务场景远比这要复杂:分段式数据存储、主从同步 读写分离、高并发同步策略等等

每一个模块都晦涩难懂

就好像每一个女神都高不可攀

屌丝战胜了所有bug,唯独战胜不了她的心

受伤了只能在深夜里独自买醉

但每当梦到女神打开我做的页面

被极致流畅的体验惊艳到

在精神高潮中享受灵魂升华

那一刻

我觉得我又行了

(完)
背景
前段时间针对某件大事件,我们用之前的一个老原生html项目,涂涂改改快速做了一个h5,由于时间紧迫直接上线了

结果没想到。。。。第二天就被某大公司抄袭了。。。调了点颜色、改了些文案就直接抄袭并上线了。。。连我们变量名都没改。。。

后来我们快速对项目代码进行了压缩和混淆,才避免了后续迭代没有被抄袭。。。

整件事说起来又气又搞笑。。。

经过这件事,我汇总了一下js、css、html压缩与混淆,增加页面加载速度的同时,还能防止页面被抄袭

js混淆
js混淆,其实就是将你的js代码弄的晦涩难懂,达到了防抄袭的效果

业界比较常用的是javascript-obfuscator这个库

const JO = require("javascript-obfuscator");
const code = `
        function add(first, second) { return first + second; }; 
        var v = add(1,2); 
        console.log(v);
`;
const result = JO.obfuscate(code,
    {
      compact: false,
      controlFlowFlattening: true,
      controlFlowFlatteningThreshold: 1,
      numbersToExpressions: true,
      simplify: true,
      shuffleStringArray: true,
      splitStrings: true,
      stringArrayThreshold: 1,
    }
  );
console.log("混淆结果:", result.getObfuscatedCode())

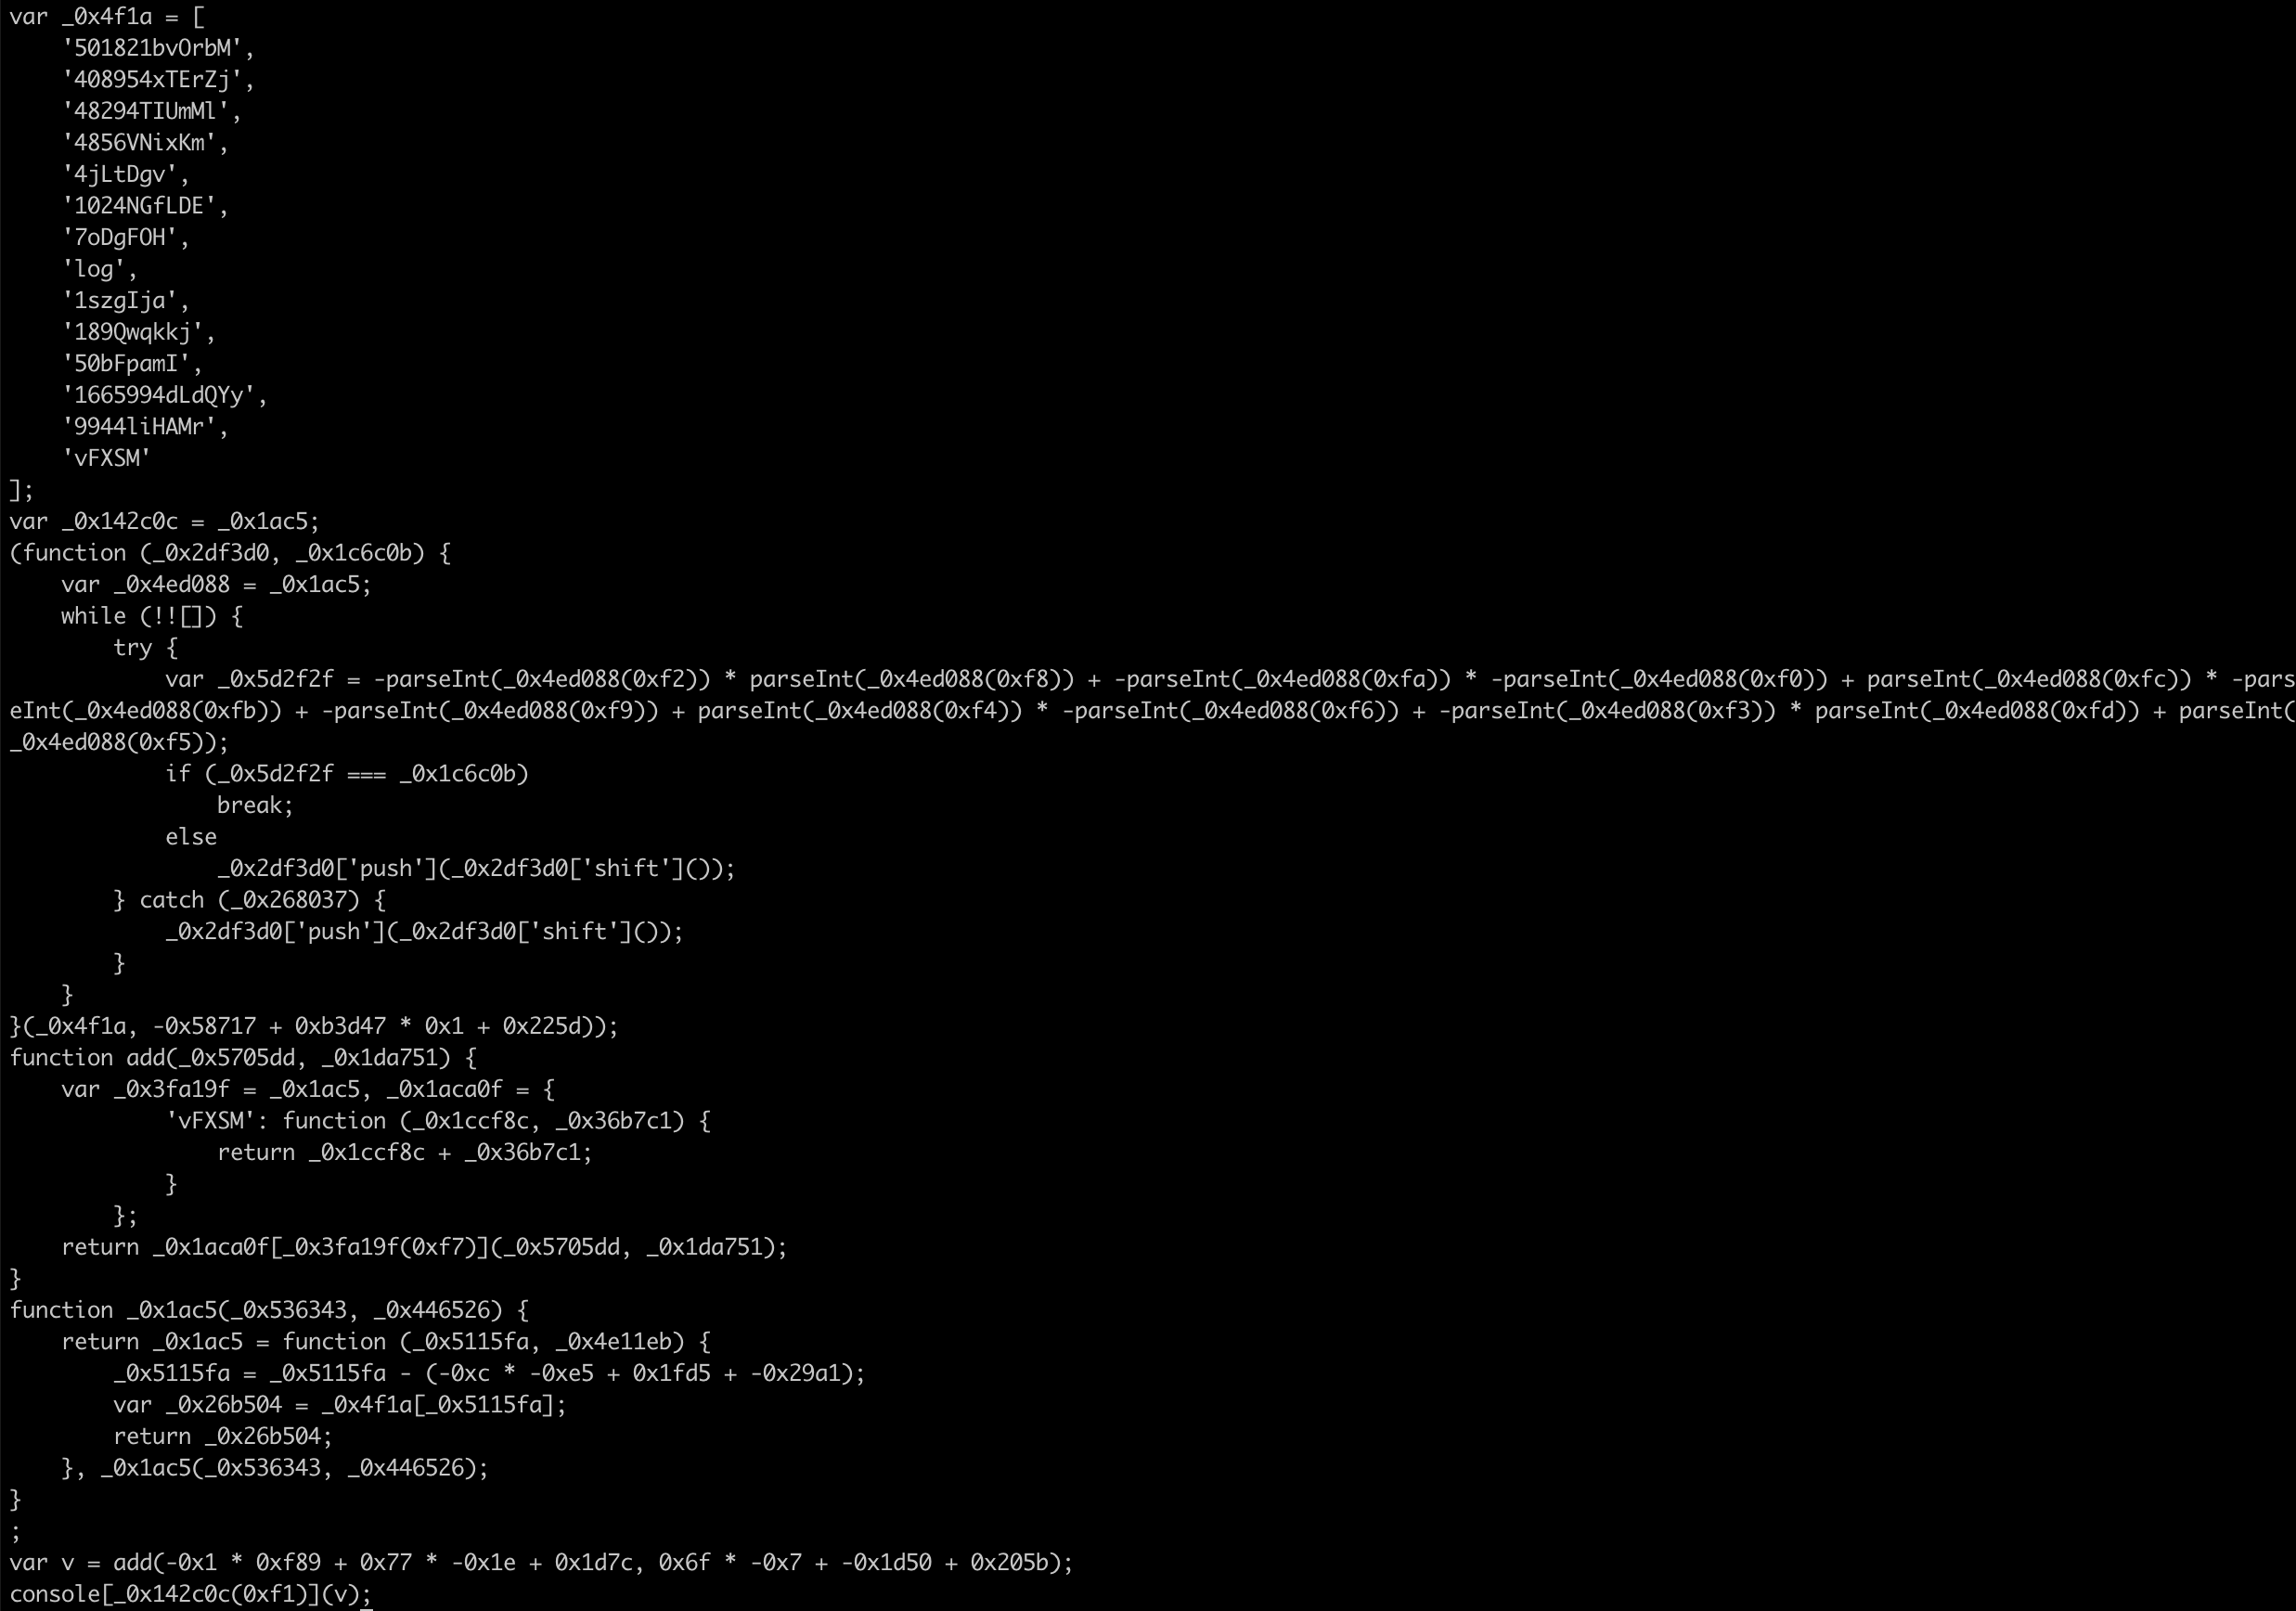
这段代码就是将一段简单的加法运算代码进行了混淆,最后结果是
2023-04-11T11:26:18.png

分析一下你会发现,其实多了一个字典,所有方法变量,都有存在字典中,调用时先调用字典还原方法名变量再执行

js压缩
压缩以前用的最多的是uglifyjs,现在用的比较多的是terser

const { minify } = require("terser");
const code = `
        function add(first, second) { return first + second; }; 
        var v = add(1,2); 
        console.log(v);
`;
const result = await minify(code);
console.log("压缩结果:", result.code)

压缩后结果如下:

function add(d,n){return d+n}var v=add(1,2);console.log(v);

将所有参数都变成了一个字符,所有能缩减的空间都去掉了,转化成一行代码,最大限度节省代码体积

css压缩
css压缩,我用的clean-css,当然业界也有很多优秀的css处理插件比如PostCSS,但这里我简单介绍一下clean-css的用法

const CleanCSS = require('clean-css');
const input = `
    a { 
        font-weight:bold; 
    }
    .vb {
        border: 1px silid red;
    }
`;
const options = { /* options */ };
const output = new CleanCSS(options).minify(code);
console.log("压缩结果:", output.styles)

压缩后的结果如下:

a{font-weight:700}.vb{border:1px silid red}

html压缩
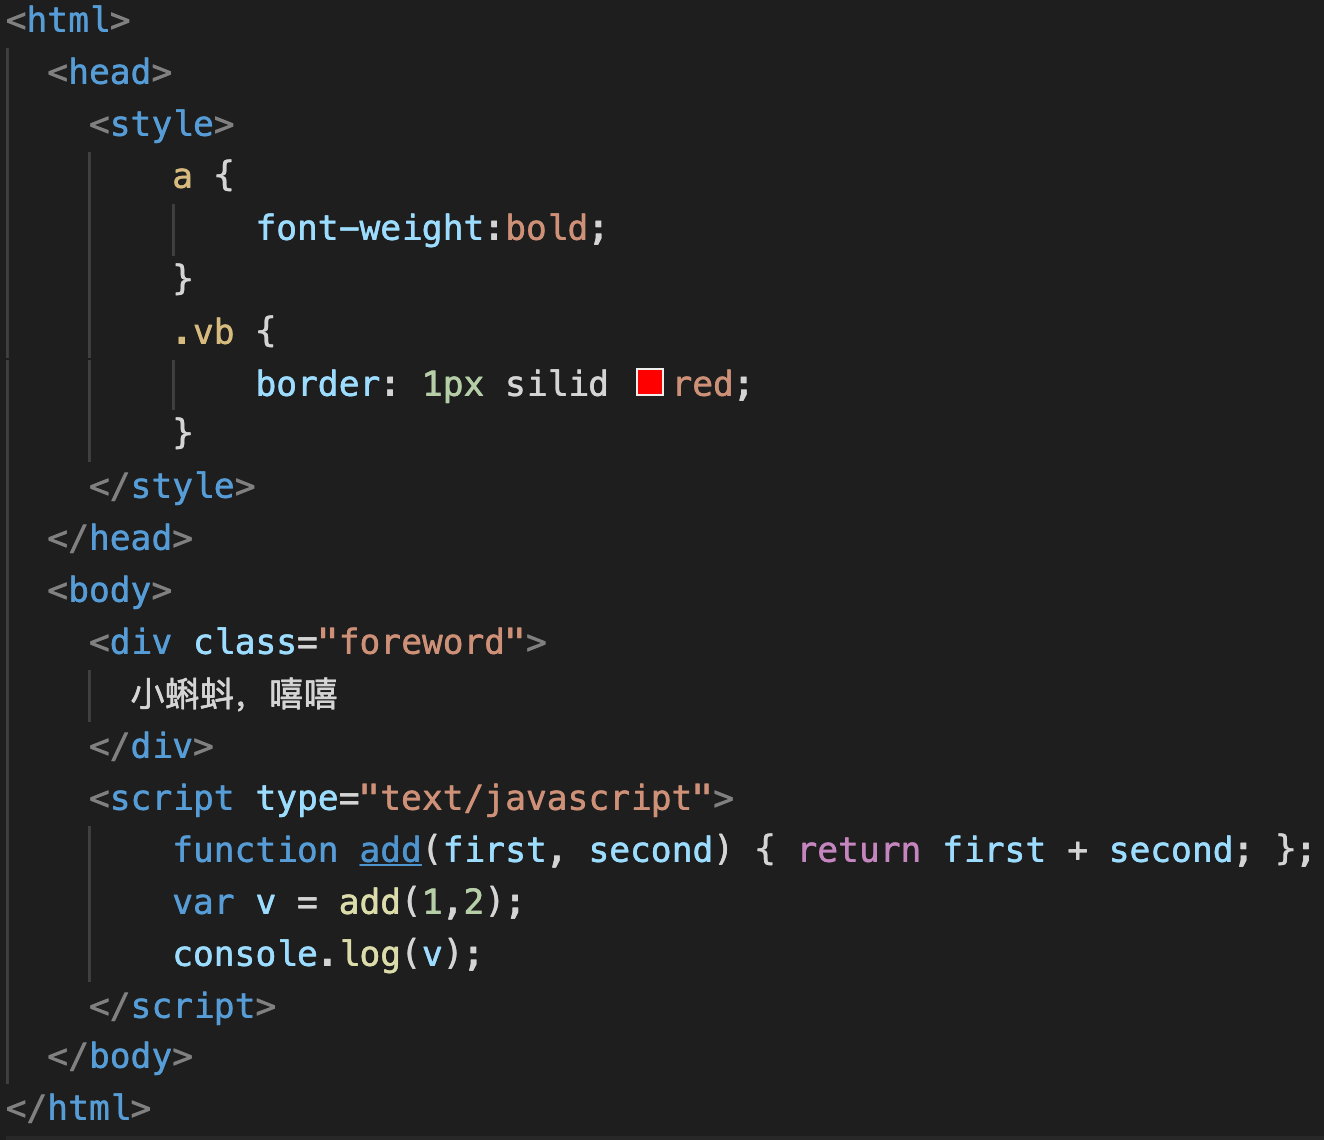
现在业界最常用的html压缩插件是html-minifier,功能很强大,还能压缩html中的js和css,直接上代码

我们压缩一段有html、js、css的代码

2023-04-11T11:27:11.png

执行压缩的代码如下:

const htmlMinify = require("html-minifier").minify
const result = htmlMinify(htmlCode, {
        minifyCSS: true,// 压缩css
        minifyJS: true,// 压缩js
        collapseWhitespace: true,// 删除html里的空格 达到html的压缩
        removeAttributeQuotes: true,// 尽可能删除html标签里的双引号 达到html的压缩
        removeComments: true, //删除html中的注释
        removeCommentsFromCDATA: true, //从脚本和样式删除的注释
    });
console.log("压缩结果:", result)

压缩结果如下:

<html><head><style>a{font-weight:700}.vb{border:1px silid red}</style></head><body><div class=foreword>小蝌蚪,嘻嘻</div><script type=text/javascript>function add(d,n){return d+n}var v=add(1,2);console.log(v)</script></body></html>

通过设置对应的配置项minifyCSS和minifyJS,我们直接把html、js、css一起进行了压缩,非常方便

唯一遗憾的是,好像html-minifier不支持js的混淆,所以js的混淆我直接抽出来单独做了

结尾
通过抄袭的这件事,反射出了我们团队上线流程的不规范

但对于被其他团队抄袭这种行为,也只能在这里道德谴责一下,发发牢骚

就当是吃一堑长一智吧,嘻嘻

重构经过了十几年的发展和应用,可以说它是极限编程中程序员最爱的实践之一了,纷纷争相在项目里应用。重构工作坊、Codekata重构练习等各种提升能力的方式也屡见不鲜,帮助程序员们去追求优秀的代码和设计。然而这仍然摆脱不了人们对它的各种抱怨:“搞什么,又重构”,“重构出defect来了”,“项目紧,最近不要再重构了”,“重构到什么时候停呀”。小菜也这样被项目中的人抱怨着,觉得很委屈,找到了大牛小明。

小菜:有一大段代码不合我意,写的很烂。我就想最近刚好新学了点技巧,看了下模式,赶紧大干一场。没想到做着做着组里都反对。
小明:那你有什么目标?重构想达到什么效果?
小菜:目标?啥意思?
小明:我们做事情得有目标,重构任务也是一样的。
小菜:我不太清楚,我就是想把这段代码改了,我删了好多代码,测试好多都红了。项目好像下周发布,项目经理小东也问我什么时候完工;测试小花还说我前两天做的功能有问题,问我是不是又重构了;
小明:你呀,今天来对了。这两天我也在琢磨这个戏,重构七宗罪,正好给你来讲一下。

1.不懂重构,为了重构而重构
“没有目标而生活,恰如没有罗盘而航行。”

做事情得有一个目标,拿出租车举例:“师傅,我要去机场”。出租车师傅很清楚我们的目的地。然如果我们说,“师傅,我就是来坐车的,你随便开吧”,就是再有经验的司机也没办法把你送到终点。重构也是一样,它需要能够解决一定的问题,要有一个目标的引领,否则黑咕隆咚做了半天也不知道自己做了啥,最后不得不全部回滚,白费工夫。

那么重构是什么,它解决什么问题呢?

所谓重构是对软件内部代码及其结构的调整,期望改善代码质量,促使程序设计架构更趋合理。说白了,重构解决的就是代码和代码结构的问题,它开始自坏味道,其目标就是要消除坏味道,消除那些“不合我意”的因素,让代码的意图更清晰。

Martin在《重构》一书中提到了22个常见的代码坏味道,都可以作为我们重构的目标,来指引我们的重构。如:

消除同一类两个方法之间的重复代码

消除某一类中的长方法

重命名

删除A类中的死代码

简化复杂的条件语句

同时,重构的范围也应是那段坏味道的代码,在重构过程中对其,也仅对其进行修改。

小菜:我明白了。这一段代码其实我就是想先去除重复问题的,结果改着改着就改到别的地方了。

2.不知道什么时候完工
经理,我先改上50块钱的,你看行不行?

重构是整理代码保持轻装前行的重要手段,然而我们也需要能够明确知道重构要做什么,最终的产出如何验证。总不能对项目经理说,我先改上50块钱的?

上文提到了消除复杂条件语句是这次重构的目标,那么简化22行-32行复杂的条件语句就是一个更具体的重构目标。有了这样一个具体清晰的目标,“重构什么时候停”也就是一个很容易回答的问题了,不用担心项目经理天天问你啥时候完工了。

2023-04-11T10:50:05.png

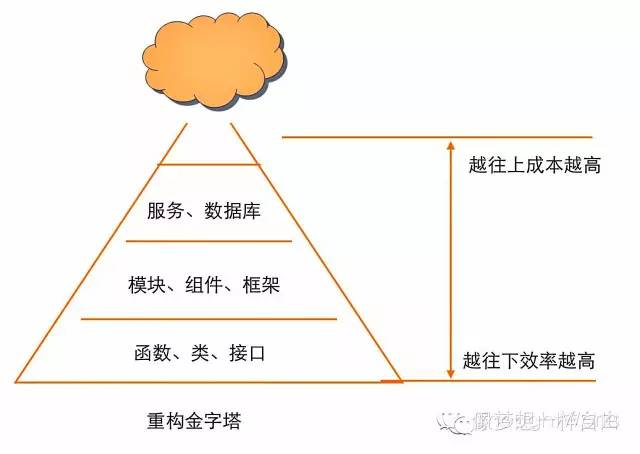
重构其实不仅有代码级别的重构,还包括模块级别的重构、架构级别的重构。不同级别的复杂度不同,消除的坏味道不同,需要的时间也不同。一般来讲代码级别的重构可以在小时和天以内,架构级别需要的时间会更长一些,比如几周或几月或几年。

3.没有方法,暴力重构
“非常的建设需要非常的破坏。”

很多人都认同这一观点。但对遗留的应用软件、构筑过半的项目却容不得推倒重来。以我观察,在开始重构时仅凭自己对代码的理解就进行剪切、复制、删除、添加等大刀阔斧修改的人不在少数,尤其还没有完全掌握重构手法的新人们。结果当然错误百出,导致测试“奖赏”一片红。修复这些错误代码少则几个小时,多则几天,这不是重构,这是重写。

小菜:那怎么破呢?

无他,苦练而已。
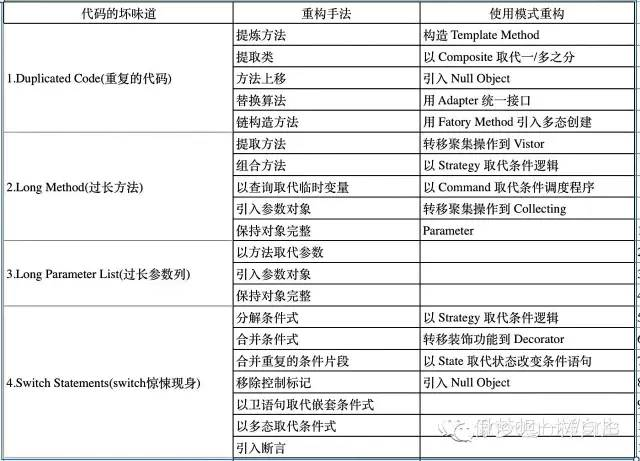
重构是一种经千锤百炼形成的有条不紊的程序整理方法。在《重构》一书中Martin明确提出了68个代码级别的重构手法,这些手法都是等价的。在重构的过程中即使错了也没关系,都可以安全回退,重新开始。其中比较常用的手法就是桥接,如当我们要删除一个方法的时候,会新添加一个方法,然后将它的引用逐一的迁移过去,直到旧方法成为孤岛,就可以将它删除了。它能保证重构前与重构后的程序代码功能完全一致,从而实现安全重构。

所以小菜啊,这是20个招式,回去加紧练习啊;三月后再来见我。

2023-04-11T10:51:05.png

小菜:是不是就像拳击比赛,不能空有一身蛮力,也得有技巧。
小明:孺子可教也。

4.没有策略,追求完美主义
重构过程中,经常出现为了消除一个坏味道,改了A类的方法,又改了B类的变量,不得不改了C类;最后发现这三者之间还有依赖,导致进行不下去了,波及面越来越广,时间越来越长,项目经理在催,最后不得不放弃所有的代码。

老子说:“治大国,如烹小鲜。”

调整一个正在运行中的系统也如治国,不要期望一次性调整到漂亮的代码或架构,而是要遵循“小步前进”的方法。从问题着手,每次重构一小步。针对一个问题有目的修改,修改完后测试,测试通过后提交代码,再进入下一轮重构。如果在改动过程中发现了其他需要修改的地方,不要顺便重构,你可以把它记下来,作为下一轮重构的内容。

这种做法在代码和模块层面都是相对比较容易实践,而针对架构层次的调整就相对比较复杂。这也是很多架构师需要去思考的问题,如何渐进式重构。不搞一下子半年一年的重构,而是以周以月为单位,快速的迭代,能够很快的验证结果获得收益。

5.不知道结果对不对
对于简单的代码级别重构如果做得好是可以不用验证结果的,然对于模块级别或架构级别的重构,是需要的。在我遇到的多次重构架构失败的例子中,很多是因为越做越发现很难验证结果的正确性,越做越不知道改的对不对,最后发现很难回答老板和客户的问题不得不失败。

这个时候一个可以衡量重构的指标就体现它的价值:能时刻检验我们的成果,确认我们的重构还在解决当初的问题。目前常见的量化指标有如下四类,可供参考。

数量:代码的行数

质量:代码复杂度、重复读、缩进等级、架构依赖复杂度等

时间:花费的天数

成本:投资回报率

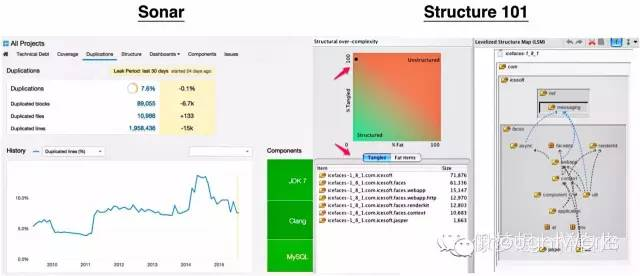
同时也可以借助于Sonar、Structure101这样的一些成熟工具度量和管理这些结果。

2023-04-11T10:51:22.png

6.只谈招式,不谈心法
《重构》是Martin和Kent对他们多年以来整理代码的实践的总结,然这背后体现的是他们对软件技术的深层次思考和经验。很多新人执着于学习重构手法而疏于学习背后的心法,有些可惜。

Robert C Martin的《代码整洁之道》和《敏捷软件开发:原则、模式与实践》、《设计模式》、Eric的《领域驱动设计:软件核心复杂性应对之道》、《架构之美》等都是帮助大家修炼心法的不错选择,他们可以让你更深层的了解代码,更高层面看待系统,锻炼你的嗅觉,提升你的代码能力。

7.不了解上下文,不与团队沟通
我们不得不承认对代码的重构是有风险的,尤其是模块或架构级别。这段代码的业务是什么,为什么当时这么设计,测试覆盖率是多少,如果这样改会不会影响到其他模块?对其他角色有什么影响?这些问题都要逐一回答。在风险相对较大的改动更要如此,需要和团队成员,各个角色,包括项目经理和客户进行沟通,谈论这次重构的好处和风险,获得足够的评估,从而能够做出合适的重构决策,将风险降到最低。

今天就聊这些吧。不过小菜啊,你不要担心,重构和做其他事情一样,要有目标有方法有策略有结果。我们在进行的时候需要以终为始,不忘本心。最重要的是要提升技术能力,学习安全重构手法,小步前进,渐进式的重构,不断验证重构的收益,才能迎接一个一个的重构任务,真正的成为清理代码的高手。

加油吧,我看好你哦。